目录 +
GEO外贸独立站需要满足哪些技术要求?从AI爬虫到Schema的建设规范
来源:创同盟
日期:2026-11-20
浏览:35
作者:创同盟|专注B2B外贸数字营销服务商
不少外贸企业开始做GEO时,会优先考虑增加产品介绍、应用方案和FAQ等内容。但内容建设只是其中一个环节。如果AI搜索系统无法正常访问网站,或者页面重要信息没有以可读取的方式输出,即使网站内容比较丰富,也可能无法充分参与AI搜索的信息检索和引用。
例如,一家工业设备制造企业在产品详情页中展示了设备型号、技术参数、应用范围和产品图片,但如果核心参数只通过前端脚本动态加载,部分爬虫可能无法正常读取;如果robots.txt或服务器安全策略限制了AI搜索爬虫访问,相关页面也可能无法进入对应的检索流程。
因此,GEO技术优化并不是单独增加一个AI文件,也不是简单配置Schema,而是需要检查网站从访问、读取到信息理解的整个过程。
对于B2B外贸独立站,建议重点检查五个方面:AI爬虫访问权限、HTML内容可读性、网站基础技术、Schema结构化数据,以及后续的技术检测与验收。
一、AI爬虫访问权限应该如何配置?
AI搜索系统需要通过相应的访问机制发现和获取网站内容。企业首先要确认目标AI平台的爬虫是否能够正常访问官网。
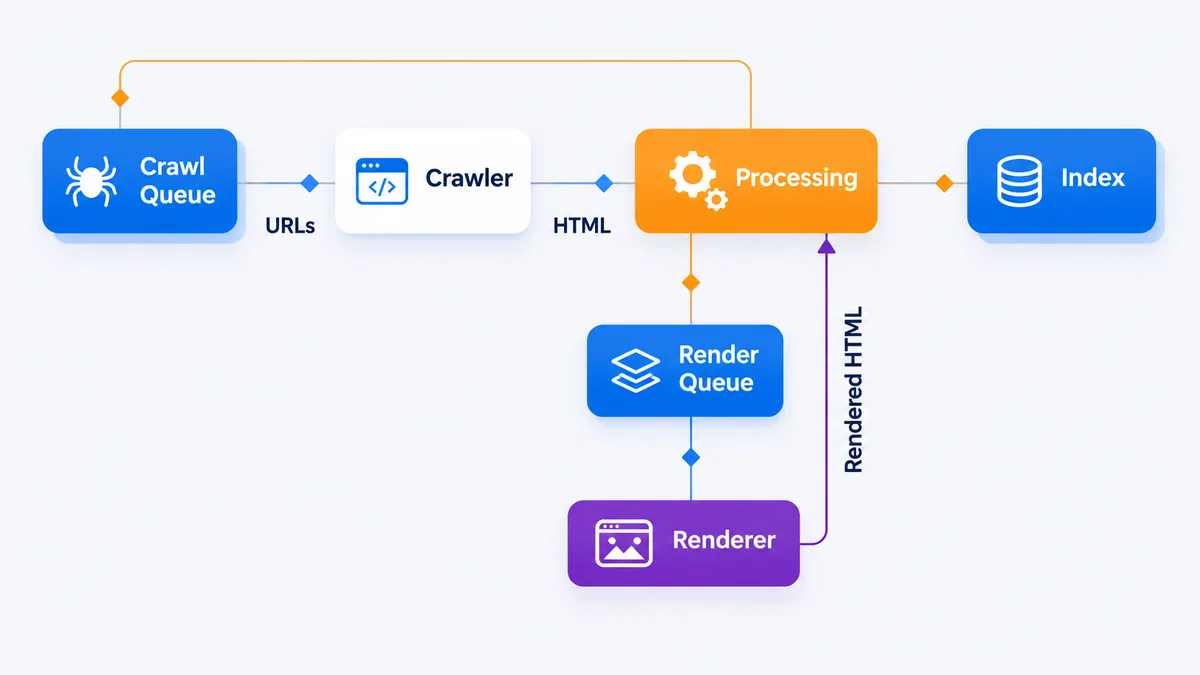
配图1:AI爬虫访问、页面渲染与索引流程|来源:创同盟整理
以OpenAI为例,常见的访问身份包括以下几种:
OAI-SearchBot:用于ChatGPT搜索功能中的网页搜索和发现。
GPTBot:用于可能参与模型训练的数据抓取。
ChatGPT-User:用于响应用户在ChatGPT中主动发起的访问,不是自动搜索爬虫。
这三者用途不同,不能简单地将它们视为同一种AI爬虫。企业需要根据自身内容使用策略,分别设置访问权限。
OpenAI官方也明确区分了这些爬虫的用途,具体可以参考:OpenAI Crawlers官方说明。
网站需要检查哪些地方?
robots.txt:确认是否通过Disallow规则阻止了目标爬虫访问重要目录或页面。
服务器访问控制:检查防火墙、CDN、WAF及安全插件是否拦截AI爬虫。
页面访问状态:确认重要页面能够正常返回HTTP 200,而不是403、404或其他异常状态。
访问日志:检查服务器日志中是否存在目标爬虫的访问记录,以及是否出现连续访问失败。
需要注意,允许AI爬虫访问,并不代表网站一定会被ChatGPT引用。它只是让网站具备参与相关搜索流程的访问条件。
二、HTML内容可读性需要达到什么要求?
AI爬虫能够访问网站,不代表一定能够完整读取页面内容。尤其是使用JavaScript开发的网站,需要进一步检查页面内容是否能够正常渲染。
Google Search Central在JavaScript SEO官方指南中,将JavaScript页面的处理分为抓取、渲染和索引三个阶段,同时指出,并不是所有爬虫都具备执行JavaScript的能力。
因此,外贸独立站建议重点检查以下内容:
1. 核心正文应当正常输出HTML
产品名称、技术参数、产品介绍、FAQ和应用内容等重要信息,建议能够在页面HTML中正常呈现,不要完全依赖用户点击、滚动或执行特定脚本后才加载。
2. H标签层级清晰
H1:明确页面核心主题。
H2:划分主要内容模块。
H3:补充具体技术内容或应用说明。
不要为了布局关键词而大量重复H1,也不要用普通文字样式代替必要的标题结构。
3. 图片应有明确的ALT描述
产品图片应根据实际展示内容设置ALT,例如:
Industrial CNC machine for precision metal component manufacturing
避免所有产品图片都使用相同的ALT,也不要将大量关键词直接堆积在图片描述中。
4. 页面基础信息完整
每个重要页面应当具有独立的Title、Meta Description、规范URL和合理的内部链接。
如果网站使用JavaScript动态生成页面内容,还需要检查渲染后的HTML是否完整,是否出现正文缺失、重复Canonical或错误的noindex设置。
建议使用Google Search Console中的URL检查工具查看Google实际抓取和渲染的页面,并结合浏览器查看源代码进行对比。
三、GEO网站还需要哪些基础技术配置?
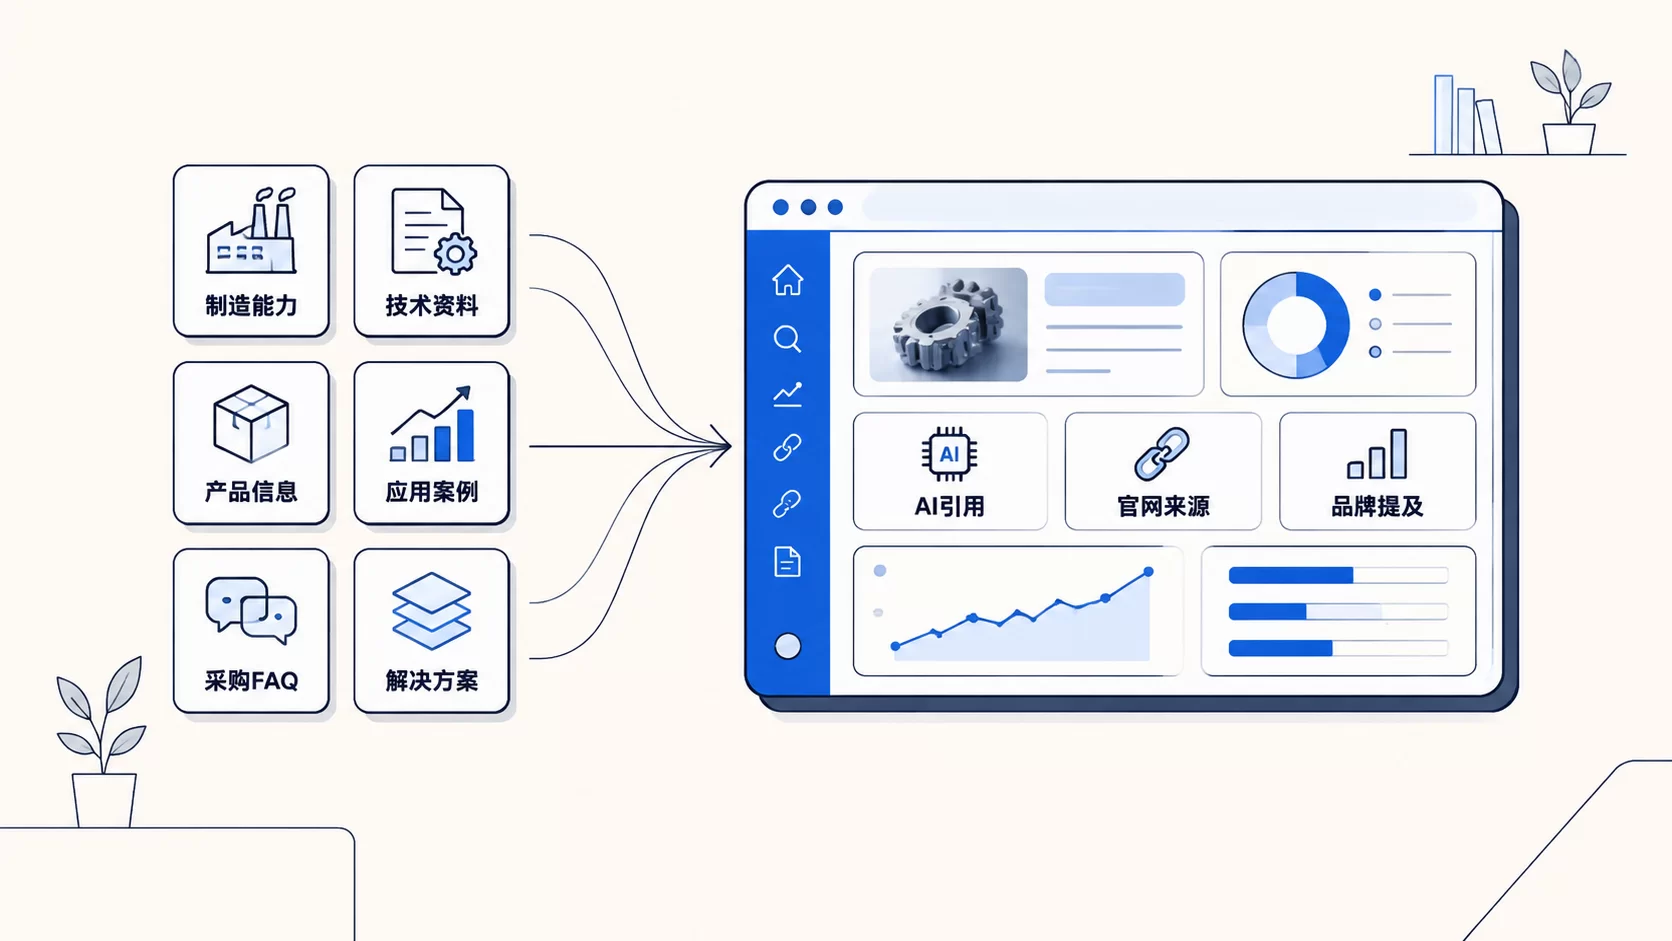
除了AI爬虫和HTML可读性,网站原有的SEO技术基础同样重要。GEO不是要推翻SEO技术体系,而是在原有网站基础上进一步保障内容能够被发现、访问和理解。
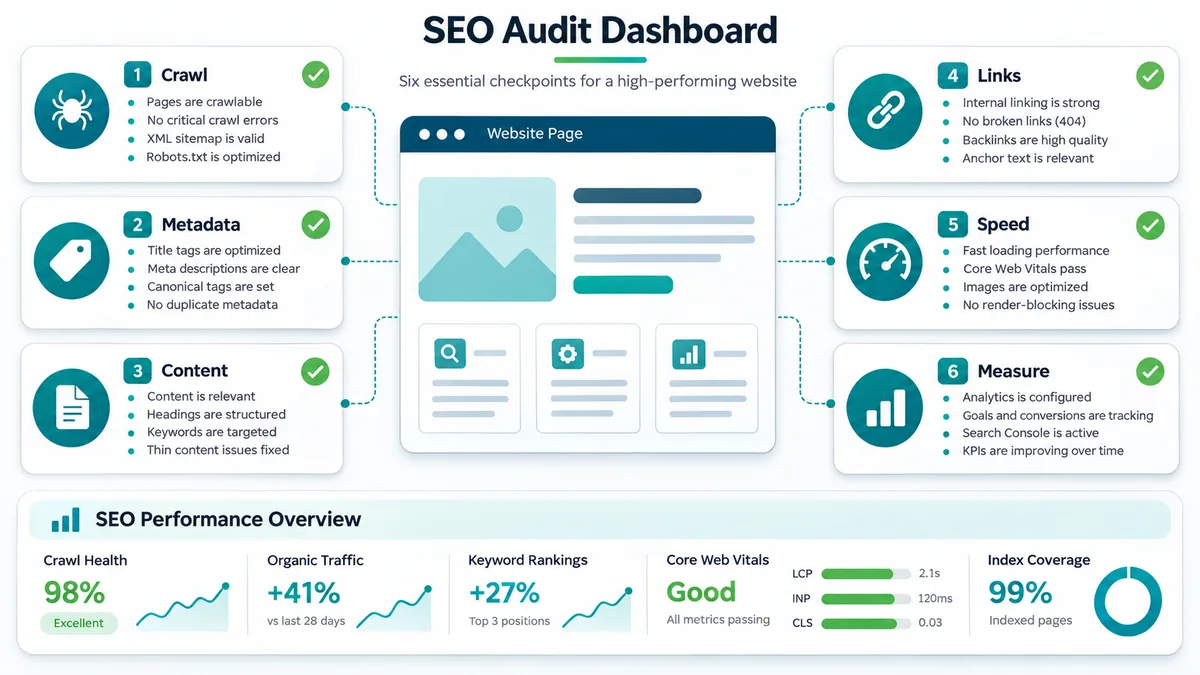
配图2:网站技术检查与SEO审计维度|来源:创同盟整理
1. Canonical规范
同一页面可能存在不同URL,例如带参数和不带参数的URL、HTTP和HTTPS版本、带www和不带www的版本,以及不同路径下重复展示的内容。需要通过Canonical明确首选URL,避免搜索引擎将重复页面当成多个独立页面处理。
具体可参考:Google Canonical URL配置指南。
2. XML Sitemap
网站应当配置XML Sitemap,将需要搜索引擎发现的重要页面纳入其中。对于B2B外贸独立站,建议重点覆盖首页和核心服务页面、产品分类及产品详情页、行业应用与解决方案页面,以及技术博客和专业指南。
同时需要注意,Sitemap中应使用规范的绝对URL,及时更新重要页面的lastmod信息,并删除已经失效或不需要索引的URL。
Google官方也明确说明,提交Sitemap只是帮助搜索引擎发现页面,并不保证页面一定被抓取或收录。
3. 内部链接结构
网站不能只依靠导航菜单连接页面,还需要建立有逻辑的内容关联。例如:产品分类页 → 产品详情页 → 对应应用方案 → 技术博客 → 相关产品。通过合理的内部链接,让搜索引擎能够发现重要页面,也方便用户从产品了解进一步进入应用和技术资料。
4. 多语言网站URL规范
对于面向不同国家市场的外贸网站,需要保证各语言页面拥有独立、稳定的URL。例如/en/为英文页面、/de/为德语页面、/fr/为法语页面。
如果不同语言页面对应相同内容,应根据实际情况配置hreflang,明确不同语言和地区版本之间的关系。不要将不同语言页面全部指向同一个Canonical,也不要让不同语言版本之间出现错误的跳转关系。
四、Schema结构化数据应该如何配置?
Schema结构化数据是GEO技术建设中值得重点检查的部分。它可以通过标准化的数据格式,帮助搜索引擎理解网页描述的是哪家企业、什么产品,以及页面属于哪种内容类型。
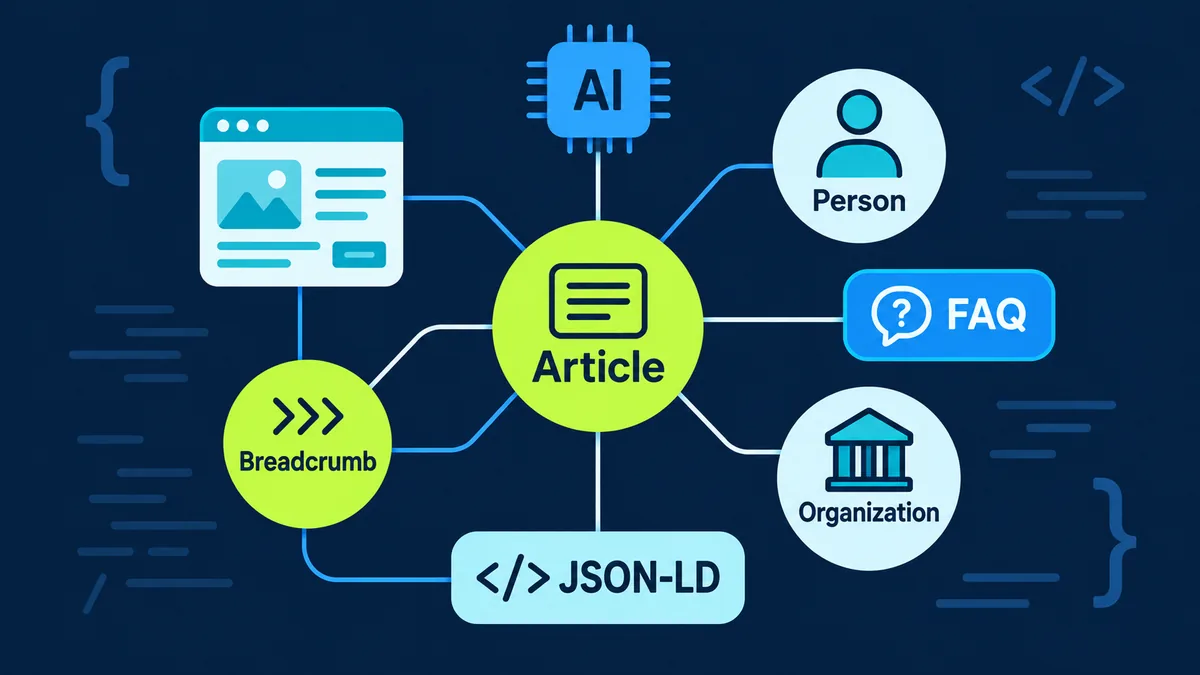
配图3:Schema结构化数据与页面信息关系|来源:创同盟整理
Google支持JSON-LD、Microdata和RDFa等结构化数据格式,其中官方推荐优先使用JSON-LD。
对于B2B外贸独立站,建议重点考虑以下几种类型:
1. Organization——企业信息
适合首页或About Us页面。可以描述企业名称及品牌名称、官方网站URL、企业Logo、联系方式、企业地址和官方社交媒体账号。需要注意,填写的信息必须与官网实际展示的企业资料一致。
参考:Google Organization结构化数据指南。
2. Product——产品信息
适合产品详情页。可以根据实际情况描述产品名称、产品图片、产品型号、品牌信息、产品描述,以及真实存在的规格和属性。
对于B2B工业设备,不能为了增加结构化数据而随意添加价格、评分、库存或不存在的产品属性。另外,Schema.org支持Product类型,并不意味着所有工业产品页面都自动符合Google商品富媒体结果的展示条件。
3. Article——文章信息
适合Blog、技术指南和行业文章。可以标记文章标题、作者、发布日期、修改日期、文章图片和发布机构。这有助于搜索引擎理解文章的基本信息。
4. BreadcrumbList——面包屑导航
适合产品、分类和博客等具有层级关系的页面。例如:Home → Products → DC Motors → Brushless DC Motor。通过BreadcrumbList描述页面在网站中的层级位置。
需要强调的是,Schema不是为了让页面堆积更多代码,而是让结构化数据与页面实际内容保持一致。如果页面没有展示某项认证、产品参数或企业信息,就不应该在Schema中虚构对应内容。Google也明确要求结构化数据必须真实反映用户能够看到的页面内容。
五、llms.txt是否需要配置?如何检测GEO技术是否合格?
目前部分GEO服务商会建议企业配置llms.txt、llms-full.txt等文件。这类文件可以作为整理网站内容入口、方便相关工具了解网站信息的辅助方式,但需要明确:它们不是OpenAI官方规定的ChatGPT引用必要条件,也不能替代robots.txt、HTML页面、Sitemap和结构化数据。
企业不必为了配置AI文件而忽略网站本身的技术问题。
那么,网站完成技术优化后,应该如何检查?建议按照下面的清单逐项验收:
| 检查项目 | 检查内容 | 推荐工具 |
|---|---|---|
| AI爬虫 | OAI-SearchBot访问权限 | robots.txt、服务器日志 |
| 页面访问 | HTTP状态码、访问限制 | 浏览器、抓取工具 |
| HTML读取 | 正文、标题、参数是否完整 | 查看源代码、URL Inspection |
| 页面规范 | Canonical、Meta、H标签 | Screaming Frog |
| Sitemap | URL是否有效、是否更新 | Google Search Console |
| Schema | 类型、属性、数据一致性 | Schema Markup Validator |
| 企业信息 | 品牌、企业名称、联系方式 | 官网人工核对 |
其中,结构化数据可以使用Schema Markup Validator检查语法和数据结构;如果涉及Google支持的富媒体结果,还可以使用Rich Results Test进一步检测。
Schema Markup Validator:https://validator.schema.org/;Rich Results Test:https://search.google.com/test/rich-results。
需要注意,两种工具的检测目的不同:Schema Markup Validator检查Schema标记,Rich Results Test主要检查Google支持的富媒体结果资格。
网站技术合格,不代表AI一定会引用。技术检查解决的是网站能否被访问、内容能否被读取、信息能否被正确理解的问题。AI最终是否引用官网,还受到搜索问题、内容相关性、信息可信度及系统检索机制等因素影响。
因此,企业完成技术建设后,还需要持续结合Google Search Console、GA4、服务器访问日志以及实际AI搜索结果进行观察。
总结
GEO外贸独立站的技术建设,不是简单增加几个AI文件或配置一套Schema代码,而是要从爬虫访问、HTML内容输出、网站基础结构、结构化数据到后续检测,建立完整的技术基础。
对于已经上线的外贸独立站,不需要为了GEO重新开发整套网站。建议先检查现有网站的技术问题,再根据实际情况确定需要调整的部分。
如果网站正处于新建或改版阶段,则应该在前期规划中考虑AI爬虫访问、页面HTML结构、Schema和多语言URL规范,避免上线后再进行大规模修复。
参考资料
深圳市创同盟科技有限公司(简称:创同盟,英文名称:CTMON)是一家成立于2013年的B2B外贸数字营销服务企业,总部位于广东省深圳市。公司主要面向制造及外贸企业提供海外数字营销相关服务,业务涵盖外贸独立站建设、搜索引擎优化(Google SEO)、Google广告推广(SEM)、海外社交媒体营销以及AI搜索优化(GEO)等领域。
创同盟基于海外采购商的搜索行为和决策逻辑开展独立站策划与营销优化,帮助企业搭建面向全球市场的线上获客体系,并将实践方法论总结为《外贸营销实战指南》。
截至2026年8月,公司全案服务客户规模超过1300家,覆盖机械设备、智能制造、新能源、电子科技、工业零部件、光通信、建筑与装饰、电气与电子、轻工业与日用品、汽车与摩托车零部件及配件、服装与配饰、照明与灯具、体育用品与休闲、交通运输、艺术与手工艺、包装与印刷、健康与医药、计算机产品等制造行业。
电话:0755-32998669 / +8618823880196
咨询电话:18138214917
邮箱:xiaomeng@ctmon.com